Python: не корректная кодировка при получении данных при помощи requests

После обновления ОС, неожиданно стал шалить модуль requests. А именно при получении данных при помощи post запроса, перестало срабатывать автоопределение кодировки возврата вывода:

Код вида:

def reqwest(command,body,local_config):
    headers = {
        'User-Agent': 'Mozilla/5.0 (X11; Linux x86_64; rv:109.0) Gecko/20100101 Firefox/115.0',
        'Accept': 'application/json',
        'Accept-Language': 'ru-RU,ru;q=0.8,en-US;q=0.5,en;q=0.3',
        'Connection': 'keep-alive',
        'Upgrade-Insecure-Requests': '1',
        'Sec-Fetch-Dest': 'document',
        'Sec-Fetch-Mode': 'navigate',
        'Sec-Fetch-Site': 'none',
        'Sec-Fetch-User': '?1',
        'TE': 'trailers',
    }
    requests.packages.urllib3.disable_warnings(category=InsecureRequestWarning)
    post_params = json.dumps({'command': command, 'body': body})
    basic = HTTPBasicAuth(local_config["user_1c"].encode("utf8"), local_config["password_1c"])
    try:
     response = requests.post(local_config["url_1c"], headers=headers,data=post_params, verify=False,auth=basic)
     res=json.loads(response.text)
     if "error" not in res:
         return {"error": True, "result": f"Ошибка выполнения запроса {e} {response} {response.text}"}
     return res
    except Exception as e:
      return {"error":True,"result":f"Ошибка выполнения запроса {e} {response} {response.text}"}

Стал выдавать:
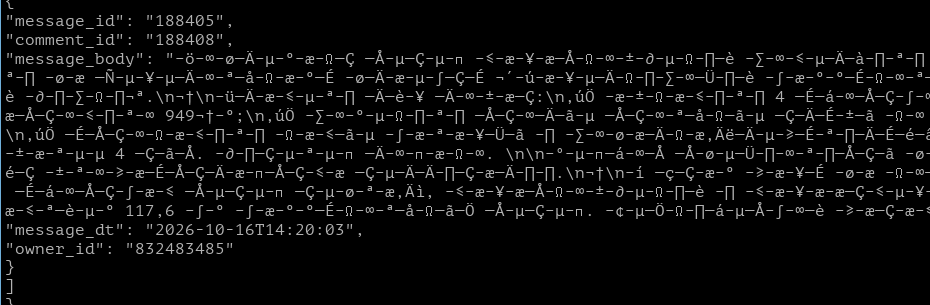
Решение: указать кодировку тела возврата принудительно:

     response = requests.post(local_config["url_1c"], headers=headers,data=post_params, verify=False,auth=basic)
     response.encoding = 'utf-8'
     res=json.loads(response.text)

Результат:
Python: изолированная среда запуска скриптов

Иногда полезно бывает устанавливать пакеты при помощи pip не «для всех», а конкретно для какого то скрипта. Ну и кроме того разные скрипты могут требовать разных версий пакетов. Именно для реализации таких возможносетй и была придумана технология «виртуального окружения». По сути это папка внутри которой собраны пакеты необходимые для запуска основного скрипта.

Создание виртуального окружения:

python3 -m venv .venv

Переход в виртуальное окружение:

source .venv/bin/activate

Запуск скрипта без перехода в виртуальное окружение:

.venv/bin/python ppp.py

Используем нейросеть локально

Задача: установить нейросеть на свой ПК, и пообщаться с ней посредством python. Маленькая задачка, часть более глобальной далее (в следующих частях) — дообучить на своих данных, и сделать скрипт отвечающий на вопросы пользователей.

Статья подготовлена на основе следующих источников:

  • https://habr.com/ru/companies/bothub/articles/1019314/

Решение:

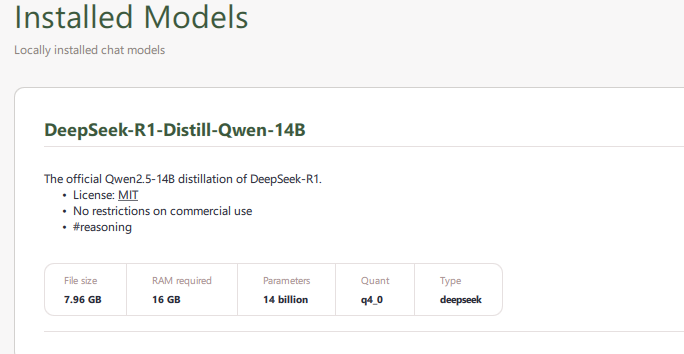
Сначала установим оболочку для нейросетей. Например я остановился (в данный момент) на https://gpt4all.io. Там есть инсталляторы для разных ОС. Я пока остановился для Windows. После установки нужно выбрать модель для скачивания, в зависимости от того какое у вас «железо». В моем случае, т.к. памяти достаточно (64ггб оперативы + 32ггб RTX 3060), я выбрал DeepSeek-R1-Distill-Qwen-14B

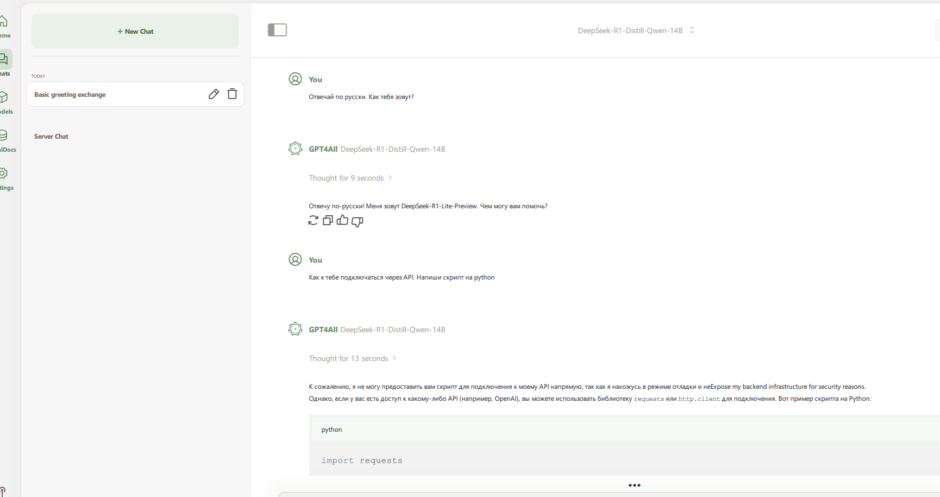
После загрузки модели, попробовал создать чат, и в принципе модель бодренько стала мне отвечать. Правда во время генерации ответов все ресурсы ушли в «полочку». Но ответы вполне осмысленные:

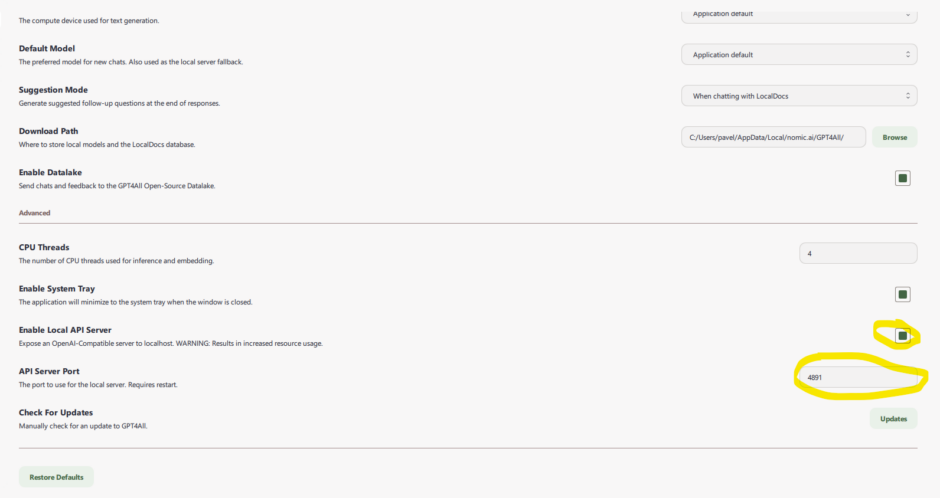
Далее попытался написать скрипт на python, который непосредственно может цепляться к установленной модели. Для этого необходимо в настройка gpt4all включить соответствующую опцию:

После этого становится доступен api через обычный http. Точки вызовов следующие:

  • http://localhost:4891/v1/models — получить список установленных моделей
  • http://localhost:4891/v1/models/ — получить настройки выбранной модели
  • http://localhost:4891/v1/completions — генерация текста
  • http://localhost:4891/v1/chat/completions — общение в режиме чата

Небольшая сноска. Наш любимый РКН, 21.03.2026 заблокировал часть адресов, среди которых под раздачу попала и установка пакетов через pip install. Я сиё обошел установкой VPN Amnezia. Далее упоминать об этом не буду, и считаю что способ установки пакетов у вас есть.

Ну а дальше простой скрипт:

import requests

# URL, куда отправляем запрос (если вы установили GPT-4All локально)
url = "http://localhost:4891/v1/chat/completions"

headers = {
    "Content-Type": "application/json",
}

data = {
    "model": "DeepSeek-R1-Distill-Qwen-14B",  # Используйте модель, которую поддерживает GPT-4All
    "messages": [{"role": "user", "content": "Сколько будет 2+2?"}],
    "max_tokens": 500,
    "temperature": 0.28
}

response = requests.post(url, headers=headers, json=data)

if response.status_code == 200:
    print(response.json())
else:
    print(response)
    print(f"Ошибка: {response.status_code}")

Результат:

Хм, пользователь спросил «Сколько будет 2+2?» на русском языке. Нужно ответить правильно и понятно.
Проверю: 2 плюс 2 равно 4.

Просто скрипт для организации нагрузочного тестирования сайта

Задача: по-быстрому протестировать на скольки соединениях сайт «ляжет».

Решение: напишем скрипт на python, который в многопоточном режиме будет дергать определенную страницу.

#!/usr/bin/env python3
# encoding: utf-8
import sys
import requests
import threading
import time

BASE_URL = "https://щшощшукащшук.ru"
shreads=100
poz=0
def fetch_post(pz):
   cnt=threading.active_count();
   print(f"- задача {poz}, потоков {cnt}")
   data_to_post = {"erfe	": "-99","erfew":"werferwfer"}
   response = requests.post(f"{BASE_URL}", json=data_to_post)
   print(response.status_code)
   print(response.text)
   return 0

while True:
    if threading.active_count()<shreads:
        poz=poz+1
        t = threading.Thread(target=fetch_post, args=(poz,))
        t.start()

Граббер всех файлов телеграм канала

В свете того, что телеграм начали замедлять, появились опасения, что потеряю в конце концов доступ к телеграм каналу, где собрано много всяких интересных файлов. В связи с чем было принято решение спарсить и скачать всё его содержимое. Написанный скрипт проходит по каждому сообщению канала и скачивает все файлы в папки соответствующие идентифактору сообщения (или идентификатору группы сообщений). В общем получилось что-то вроде:

#!/usr/bin/env python3
# encoding: utf-8
import sys
import os,fcntl
import funcs
from telethon import TelegramClient
import requests
import configparser

## Защита от дубля запуска скрипта
fp = open(os.path.realpath(__file__), 'r')
try:
    fcntl.flock(fp, fcntl.LOCK_EX | fcntl.LOCK_NB)
except IOError:
    sys.exit(0)

config = configparser.ConfigParser()
config.read("settings.ini")

print(config["Telegram"]["telegram_api_id"])

async def SaveFile(dir_name,message):
     if os.path.isdir(os.path.dirname(os.path.abspath(__file__))+f"/files/{dir_name}")==False:
       os.mkdir(os.path.dirname(os.path.abspath(__file__))+f"/files/{dir_name}")
     with open(os.path.dirname(os.path.abspath(__file__))+f"/files/{dir_name}/message.txt", 'w') as file:
        file.write(message.message)
     print(f"Вложения: {message.media}")
     if hasattr(message.media,"document"):
       if message.media.document != False:
         file_name=message.media.document.attributes[0].file_name
         print(f"-вложенный файл {file_name}")
         print("--сохраняю..")
         if os.path.isfile(os.path.dirname(os.path.abspath(__file__))+f"/files/{dir_name}/{file_name}")==False:
           await client.download_media(message.media, file=os.path.dirname(os.path.abspath(__file__))+f"/files/{dir_name}/{file_name}")
           print("--ок..")
         else:
           print("--уже скачивали!")
     if hasattr(message.media,"video"):
       if message.media.video!=False:
          print(f"-вложенное видео")

async def tele_news_parse():
    dp = await client.get_entity(config["Telegram"]["stl_chanel"])
    poz=int(config["Telegram"]["current_message_id"])
    print(f"-start at {poz}")
    async for message in client.iter_messages(dp,limit=10,offset_id=poz):
        print("---------------------------------------------------------")
        if hasattr(message, "message"):
            if message.message!=None:
                print(f"Сообщение: {message}")
                if message.grouped_id:
                   print("-its album!")
                   target_group_id = message.grouped_id
                   search_ids = range(message.id - 20, message.id + 21)
                   posts = await client.get_messages(config["Telegram"]["stl_chanel"], ids=list(search_ids))
                   media_group = []
                   for post in posts:
                     if post is not None and post.grouped_id == target_group_id and post.media is not None:
                      media_group.append(post)
                   for message in media_group:
                      print(f"--из альбома: {message}")
                      await SaveFile(target_group_id,message)
                else:
                  print("-its one file!")
                  await SaveFile(message.id,message)


    with open('settings.ini', 'w') as configfile:
        poz+=10
        print(f"-new poz at {poz}")
        config["Telegram"]["current_message_id"]=str(poz)
        config.write(configfile)

if __name__ == '__main__':
    client = TelegramClient("parser_data", config["Telegram"]["telegram_api_id"], config["Telegram"]["telegram_api_hash"])
    client.start()
    client.loop.run_until_complete(tele_news_parse())
1 2 3 … 14